
Lokale Browser-Agenten: Webdaten für Business Intelligence erschließen
Vier BI-Anwendungsfälle, drei eigene Abbildungen und ein geprüftes Python-Demo mit Code, Testdaten und Download.
Ein lokaler Browser-Agent kann Daten aus einer Weboberfläche für Business Intelligence erschließen, wenn ein benötigter Export oder eine geeignete API fehlt. Er liest die sichtbare Seite, bedient Suche und Filter und überführt das Ergebnis in einen prüfbaren Datensatz. „Lokal“ beschreibt dabei zunächst, wo Browser und gegebenenfalls Sprachmodell laufen. Es sagt noch nichts darüber aus, ob die besuchte Website Daten ins Netz sendet, ob eine Sitzung geschützt ist oder ob die Nutzung der Daten erlaubt ist.
Der sinnvolle Einsatz ist eng: Wiederkehrende Abfragen mit überschaubarer Menge, klar definierten Feldern und einem Menschen, der die erste Ausgabe prüft. Für große oder zeitkritische Datenströme ist eine Browseroberfläche meist die falsche Schnittstelle. Entscheidend ist auch nicht, ob ein KI-Agent besonders geschickt klickt, sondern ob der Datenstand danach nachvollziehbar, vollständig und für die Datenpipeline verwendbar ist.
Im eigenen Python-Beispiel bedienen wir eine lokale Testseite in vier Schritten und lesen zwei synthetische Umsatzdatensätze aus. Code, Browserausgabe und CSV lassen sich gegeneinander prüfen. Der geprüfte Replay verwendet vorgegebene Aktionen; eine optionale lokale Modellanbindung wird getrennt erklärt.
Was ein Browser-Agent für BI tatsächlich leistet
Ein klassisches Browser-Skript kennt seine Schritte im Voraus: Es öffnet eine Seite, trägt einen Wert in ein Suchfeld ein und liest bestimmte Tabellenzellen. Ein KI-gestützter Browser-Agent kann zusätzlich aus dem aktuellen Seitenzustand einen nächsten Schritt vorschlagen. Wenn ein Filter anders heißt oder nach einer Suche eine weitere Auswahl erscheint, plant er anhand der Beobachtung neu. Die Browsersteuerung führt nur erlaubte Aktionen aus und prüft anschließend das Resultat.
Das ist keine magische Datenquelle. Die Daten bleiben so verlässlich wie die Oberfläche und die fachliche Bedeutung ihrer Felder. Ein angezeigter „Umsatz“ kann brutto, netto, vorläufig oder zeitversetzt sein. Der Agent muss deshalb neben dem Zahlenwert auch Zeitraum, Einheit, Filter, Abrufzeit und Herkunft festhalten. Für die Weiterverarbeitung braucht es eine klare Definition der Kennzahl und Regeln zur Datenqualität.
Die Grenze zwischen Datenbeschaffung und Entscheidung bleibt sichtbar: Ein Browser-Agent sammelt und strukturiert Belege. Er entscheidet nicht allein, ob zwei ähnlich benannte Kennzahlen zusammengeführt werden dürfen. Wer einen KI-Agenten erstellen will, sollte mit einem kleinen, messbaren Datenausschnitt beginnen und die fachliche Freigabe der Zuordnung separat vorsehen.
Wann API, Export, Skript oder KI-Planer passen
Prüfen Sie zuerst die Schnittstelle, nicht das Modell. Eine dokumentierte API ist meist die beste Wahl, wenn sie die benötigten Felder und Nutzungsrechte abdeckt: Antworten sind strukturiert, Abfragen lassen sich versionieren und Fehler gezielt behandeln. Ein offizieller CSV- oder Excel-Export ist oft ausreichend, wenn die Daten nur wöchentlich oder monatlich gebraucht werden. Er kann sogar die bessere Ausgangsbasis sein, wenn die Oberfläche Werte rundet, der Export aber Rohwerte enthält.
Ein festes Browser-Skript lohnt sich, wenn die gleiche freigegebene Maske regelmäßig bedient wird und sich ihre Struktur selten ändert. Es ist einfach zu prüfen: Eingabe, Klickfolge und erwartete Tabelle sind festgelegt. Die Playwright-Dokumentation empfiehlt für robuste Selektoren unter anderem Rollen und zugängliche Namen statt rein visueller Positionen. Das verhindert nicht jede Änderung der Website, macht einen Ablauf aber verständlicher.
Ein KI-Planer kommt erst hinzu, wenn die Oberfläche mehrere zulässige Wege bietet oder die Reihenfolge einzelner Schritte vom beobachteten Zustand abhängt. Sein Nutzen muss gegen zusätzlichen Prüfaufwand, Laufzeit und Fehlerrisiko stehen. Eine feste Ergebnisstruktur und eine begrenzte Menge möglicher Browseraktionen sind wichtiger als ein offener Auftrag wie „Finde alle interessanten Zahlen“. Unterstützt das lokale Modell strukturierte Ausgaben oder Werkzeugaufrufe, kann das die Schnittstelle zwischen Vorschlag und Ausführung erleichtern; Ollama dokumentiert strukturierte Ausgaben und Werkzeugaufrufe. Die fachliche Richtigkeit folgt daraus nicht.
Eine praktische Auswahlregel lautet: API, wenn verfügbar und passend; sonst offizieller Export; sonst festes Skript; erst bei tatsächlich wechselnden Oberflächen ein KI-Planer. Diese Reihenfolge ist eine Arbeitsheuristik, keine allgemeine Rangliste. Falls eine Website automatisierte Zugriffe untersagt, eine Anmeldung verweigert oder eine Sperre setzt, endet der Ablauf dort. Ein Browser-Agent ist kein Weg um Zugangsbeschränkungen.

Der Arbeitszyklus: beobachten, planen, prüfen, ausführen, neu lesen
Ein kontrollierter Durchlauf beginnt mit einer Beobachtung: URL, Seitentitel, sichtbare Eingabefelder, Tabellenüberschriften und gegebenenfalls der angemeldete Bereich. Der Planer schlägt genau eine nächste Aktion vor, etwa „Suchfeld Umsatz mit 2025 füllen“. Vor der Ausführung prüft ein festes Programm, ob diese Aktion erlaubt ist: richtige Domain, bekanntes Element, zulässiger Wert, keine Änderung von Geschäftsdaten. Erst dann klickt oder tippt der Browser.
Danach wird die Seite erneut gelesen. Ist der erwartete Filter gesetzt? Hat sich die Ergebnistabelle geändert? Sind Überschriften, Zeilenanzahl und Einheiten plausibel? Ein fehlender Treffer, ein Dialogfenster oder eine Anmeldung ist ein neuer Zustand und kein Anlass, dieselbe Aktion blind zu wiederholen. Nach wenigen erfolglosen Schritten sollte der Lauf mit einer verständlichen Diagnose stoppen.
Für eine fortgesetzte Sitzung kann der Browser Anmeldestatus speichern. Das erleichtert wiederkehrende Abfragen, schafft aber ein Schutzobjekt: Der Playwright-Leitfaden zur Authentifizierung weist darauf hin, dass gespeicherter Browserzustand sensible Cookies enthalten kann. Solche Dateien gehören nur in einen geschützten lokalen Speicher und niemals in ein öffentliches Repository. Auch mit persistenter Sitzung bleibt jeder Abruf ein neuer Datenstand; Zeitstempel und Quellbezug gehören zum Ergebnis.

Vom Seiteninhalt zum belastbaren Datensatz
Für BI braucht der Agent mehr als eine kopierte Tabelle. Das Extraktionsschema sollte pro Zeile mindestens die fachlichen Schlüssel, den Wert, seine Einheit, den betrachteten Zeitraum und die Quelle verlangen. Darauf folgen technische Prüfungen: Sind Pflichtfelder vorhanden? Ist ein numerischer Wert wirklich numerisch? Gibt es doppelte Schlüssel, Summenzeilen oder abgeschnittene Seiten? Ein Abgleich gegen einen bekannten Export oder eine manuell geprüfte Stichprobe ist oft aussagekräftiger als ein plausibel klingender Modelltext.
Eine zweite Prüfung ist fachlich: Die Summe einzelner Zeilen darf nur dann mit einem Dashboardwert verglichen werden, wenn Filter und Definition gleich sind. Bei Abweichungen bleibt der Rohabruf erhalten, und die Zeile bekommt einen Prüfstatus. Sie stillschweigend zu korrigieren würde aus einer unsicheren Beobachtung eine scheinbar sichere Kennzahl machen.
Vier mögliche Anwendungen im BI-Alltag
Die folgenden Fälle sind hypothetisch. Sie zeigen sinnvolle Eingaben, erwartete Ergebnisse und eine unabhängige Kontrolle; sie sind keine Kundenbeispiele oder Leistungsnachweise.
1. Monatsumsätze aus einem Partnerportal
Eingabe: Ein berechtigter Mitarbeiter wählt im Portal „Januar bis März 2025“, Währung Euro und Status „abgerechnet“. Ein Export fehlt. Ergebnis: Eine Tabelle mit Monat, Partnerkennung, Nettoumsatz, Währung und Abrufzeit wird als CSV abgelegt. Validierung: Der Browser-Agent zählt die sichtbaren Zeilen, erkennt eine mögliche zweite Ergebnisseite und vergleicht die Monatssummen mit den im Portal angezeigten Gesamtwerten. Weichen die Summen ab, wird der Lauf zur Prüfung markiert. Er rät keine fehlenden Partnerkennungen.
2. Öffentliche Förderstatistik mit wechselnden Filtern
Eingabe: „Bewilligte Projekte nach Bundesland und Jahr 2024“ auf einer öffentlich zugänglichen Statistikseite. Ergebnis: Pro Bundesland ein Wert mit der exakt angezeigten Definition, Einheit und Quellen-URL. Validierung: Der Agent liest die aktiven Filter nach jeder Auswahl erneut und prüft, ob die Anzahl der Bundesländer und der Gesamtwert zur angezeigten Ansicht passen. Gibt es einen offiziellen Download derselben Auswertung, erhält dieser Vorrang; die Browserabfrage dient dann nur als Gegenprobe.
3. Preis- und Verfügbarkeitsbeobachtung eigener Angebote
Eingabe: Eine kleine Liste eigener, öffentlich sichtbarer Angebotsseiten mit Artikelkennung und Sollpreis. Ergebnis: Ein Tagesprotokoll mit angezeigtem Preis, Verfügbarkeit, Abrufzeit und URL. Validierung: Ein Preis ohne Währung oder mit unklarer Variante wird nicht übernommen. Stichproben werden im Browser mit dem gespeicherten Screenshot verglichen. Für eine breite Marktbeobachtung braucht es zusätzlich geklärte Nutzungsbedingungen und ein tragfähiges Abfragekonzept; der kleine Fall dient der Kontrolle eigener Veröffentlichungen.
4. Auftragsstatus aus einem internen Webportal
Eingabe: Eine Liste freigegebener Auftragsnummern und die berechtigte Portalsitzung. Ergebnis: Pro Auftrag der sichtbare Status und dessen Zeitstempel, damit ein internes Reporting offene Vorgänge markieren kann. Validierung: Jede Auftragsnummer wird gegen die Ergebniszeile abgeglichen; „kein Treffer“ bleibt ein eigener Zustand. Der Agent öffnet keine Änderungsmaske und löst keine Statusänderung aus. Einzelne kritische Vorgänge werden von einer verantwortlichen Person geprüft, bevor sie in operative Entscheidungen einfließen.
Ein kleines localhost-Beispiel zum Nachvollziehen
Unser reproduzierbares Beispiel verwendet eine lokale Webseite mit dem Suchfeld „Kennzahl suchen“ und einer synthetischen Ergebnistabelle. Es gibt keine Anmeldung, keine echten Unternehmensdaten und keine externe Datenquelle. Die Aufgabe lautet: „Suche nach Umsatz und lies die passenden Zeilen aus.“ Der Browser soll das Suchfeld finden, den Suchbegriff eintragen, die angezeigten Spalten und Zeilen erneut lesen und die Werte samt Zeitraum mit der bekannten Ausgangstabelle vergleichen.
Python-Demo starten
Das Downloadpaket mit vollständigem Python-Code, Testseite und Beispielausgaben enthält alles für die Browserstrecke. Entpacken Sie es, wechseln Sie in den Ordner demo und führen Sie aus:
python3 -m pip install -r requirements.txt
python3 -m playwright install chromium
python3 agent.py --replay --output ausgabe
Die ersten beiden Befehle richten Pakete und Chromium ein. Für unseren Lauf waren sie bereits vorhanden. Geprüft wurden Python 3.12.2, Playwright 1.49.1 und Requests 2.32.5. Ein erfolgreicher Lauf schreibt Aktionsprotokoll, CSV, JSON, Screenshot und einen Beleg mit Quell-URL, UTC-Abrufzeit sowie Prüfergebnis in ausgabe.
Der folgende Validator aus dem Download, ergänzt um Aktionsliste und Beispielaufruf, ist einzeln ausführbar. stage bezeichnet den erwarteten Schritt; nur vier Aktionen in der festgelegten Reihenfolge werden akzeptiert:
ACTIONS = ("fill_search", "click_search", "read_results", "finish")


def validate_action(raw, stage):
    if type(raw) is not dict or set(raw) != {"action", "value"}:
        raise ValueError("Aktion muss genau action und value enthalten")
    action, value = raw["action"], raw["value"]
    if type(action) is not str or action not in ACTIONS or type(value) is not str:
        raise ValueError("Unerlaubte Aktion oder ungültiger Werttyp")
    if action == "fill_search" and value != "Umsatz":
        raise ValueError("Diese Demo erlaubt nur den Suchwert Umsatz")
    if action != "fill_search" and value != "":
        raise ValueError("Nur fill_search darf einen Wert haben")
    if action != ACTIONS[stage]:
        raise ValueError(f"Im Schritt {stage + 1} ist nur {ACTIONS[stage]} erlaubt")
    return action, value

print(validate_action({"action": "fill_search", "value": "Umsatz"}, stage=0))
Die Browsersteuerung ruft diesen Validator vor dem Füllen oder Klicken auf. Der vollständige Code im ZIP startet Server und Browser, beobachtet den Zustand nach jeder Aktion und beendet beides nach dem Lauf.
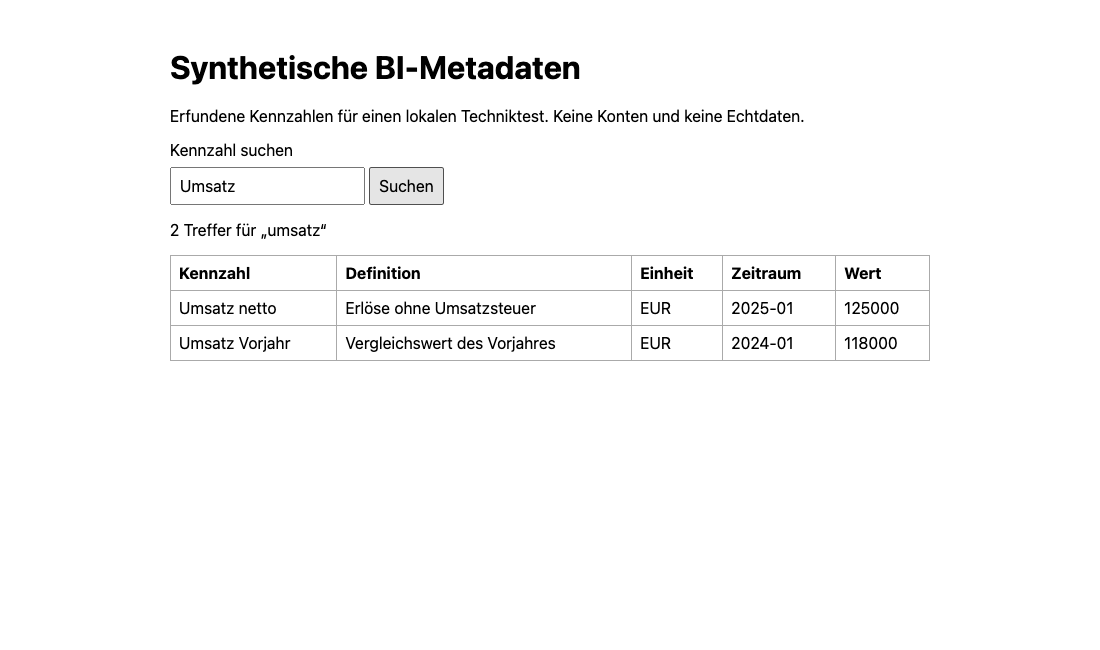
Der --replay-Modus spielt eine vorgegebene Aktionsfolge ab. Dadurch lässt sich die Browser- und Prüfstrecke ohne laufenden Modellserver reproduzieren. Für den optionalen Modellweg muss Ollama bereits lokal laufen und das gewählte Modell vorhanden sein: python3 agent.py --model llama3.2:3b. Der Code übergibt Beobachtung und JSON-Schema an 127.0.0.1:11434/api/chat. Diesen Modellweg haben wir mangels laufendem Ollama-Dienst nicht getestet. Der Ablauf bleibt absichtlich fest vorgegeben; das Modell darf jeweils nur den erwarteten nächsten Schritt vorschlagen. Der Replay-Lauf zeigt, ob die Navigation und Extraktion im Demo funktionieren; er misst nicht die Qualität eines Sprachmodells. Für einen solchen Nachweis bräuchte es eigene Testfälle mit variierenden Seitenzuständen, Fehlerszenarien und vorab festgelegten Bewertungskriterien.
Was der ausgeführte Test zeigt
| Kennzahl | Zeitraum | Wert | Einheit |
|---|---|---|---|
| Umsatz netto | 2025-01 | 125000 | EUR |
| Umsatz Vorjahr | 2024-01 | 118000 | EUR |
Der tatsächliche Lauf enthielt vier akzeptierte Schritte: fill_search, click_search, read_results, finish. Die zwei extrahierten Zeilen stimmten mit dem finalen Browser-DOM überein; die geschriebene CSV wurde erneut eingelesen und ebenfalls abgeglichen. Eine unerlaubte Navigationsaktion und fehlerhaftes JSON wurden in zwei gesonderten Testläufen vor einer Seitenaktion abgelehnt.
Die Werte aus verschiedenen Zeiträumen werden nicht addiert. Ein DOM-/CSV-Abgleich belegt hier die korrekte Übertragung der synthetischen Angaben. Die fachliche Richtigkeit realer Quelldaten und die Leistungsfähigkeit eines Sprachmodells müssten separat untersucht werden.
Die Demo ist absichtlich klein. Sie zeigt die Nahtstelle zwischen Aktionsvorschlag, Browseraktion und überprüfbarem Ergebnis. Für ein echtes Portal müssten zusätzlich Zugriff, Datenrechte, Fehlergrenzen, Aufbewahrung und die Definition jeder Kennzahl festgelegt werden.
Lokal heißt nicht automatisch offline oder datenschutzkonform
Ein lokales Sprachmodell kann auf dem eigenen Rechner rechnen. Der Browser kann gleichzeitig eine externe Website aufrufen und dabei Suchbegriffe, Cookies, IP-Adresse und andere Verbindungsdaten übertragen. Auch Modell-Downloads, Telemetrie anderer Komponenten oder eine versehentlich konfigurierte Cloud-Schnittstelle gehören zum gesamten Datenfluss. Wer „offline“ zusagt, muss diesen Datenfluss konkret prüfen und einen vollständig lokalen Testaufbau verwenden. Die localhost-Demo erfüllt nur für ihre eigenen synthetischen Daten diesen engen Zweck.
Webseiteninhalt ist zudem eine unsichere Eingabe für den Planer. Er kann neben Daten auch Anweisungen enthalten, die den Agenten zu einem anderen Verhalten drängen. OWASP beschreibt diese indirekte Prompt Injection als Risiko bei externen Quellen. Daher darf Seitentext keine Regeln, Ziel-Domain oder Berechtigungen ändern. Der Agent erhält nur Leserechte und wenige fest definierte Aktionen; sensible Folgehandlungen verlangen eine gesonderte Prüfung. Ausgabeformate werden technisch validiert, nicht nur im Prompt erbeten.
Ob eine konkrete Verarbeitung zulässig ist, hängt von Datenart, Zweck, Berechtigungen und den Bedingungen der Quelle ab. Das ist eine organisatorische und gegebenenfalls rechtliche Prüfung, keine Eigenschaft der Software. Die Beispiele hier sind keine Rechtsberatung. Für personenbezogene oder vertrauliche Daten sollten Sie zuerst klären, ob ein Export oder eine interne Schnittstelle den Bedarf mit weniger Zugriff und besserer Nachvollziehbarkeit deckt.
Wann sich der Aufwand lohnt
Lokale KI-Agenten im Browser sind für BI dann interessant, wenn eine wichtige, rechtmäßig zugängliche Kennzahl nur über eine Oberfläche erreichbar ist, die Abfrage wiederkehrt und ein klarer Prüfmaßstab existiert. Fehlen diese Bedingungen, schafft ein Agent leicht eine aufwendige Fehlerquelle. Ein guter Pilot nimmt deshalb eine Quelle, einen Suchvorgang und wenige Pflichtfelder. Er dokumentiert auch den Abbruchfall und entscheidet erst nach überprüften Ergebnissen, ob der Ablauf in die laufende Datenversorgung gehört.
Wenn Sie aus solchen Einzelabfragen eine verlässliche Grundlage für Berichte aufbauen möchten, beginnen Sie bei Kennzahlendefinition, Quellpriorität und Qualitätsregeln. Ein BI-Erstgespräch kann genau diese Architektur klären, bevor Browseraktionen automatisiert werden.